Необоснованная эффективность BM25 в агентном поиске
Почему 30-летняя лексическая функция оценки переживает колоссальный ренессанс в эпоху автономных AI-агентов, как переписать запросы с эффективностью GPT-5 и почему архитектура «BM25 + ripgrep» бьет сложные нейропоисковые пайплайны.
Главный парадокс доклада
«BM25 не стал внезапно магическим. Изменилась не формула — изменился пользователь. Вместо ленивого человека с 2 словами в строке поиска мы получили AI-агента, знающего миллионы сущностей и строящего изощренные многошаговые сессии».
Краткая выжимка: 4 столпа нового поиска
Ключевые инсайты доклада для тех, кто строит агентов, RAG-системы и инфраструктуру поиска.
Агент не похож на человека
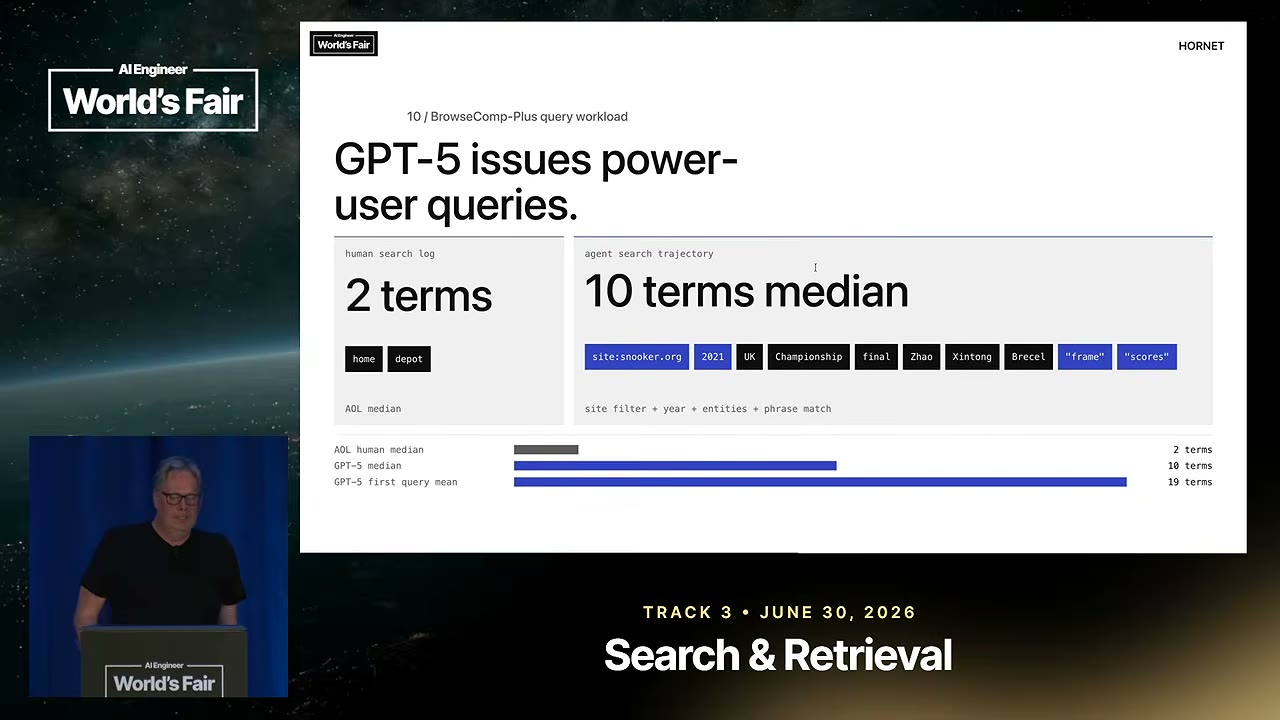
Люди со времен логов AOL 2006 года пишут 2–3 слова. LLM-агент формулирует запросы медианой в 10 слов, использует операторы site:, точные фразы в кавычках и перезапускает поиск десятками итераций.
Окно контекста — дискета 1.44 МБ
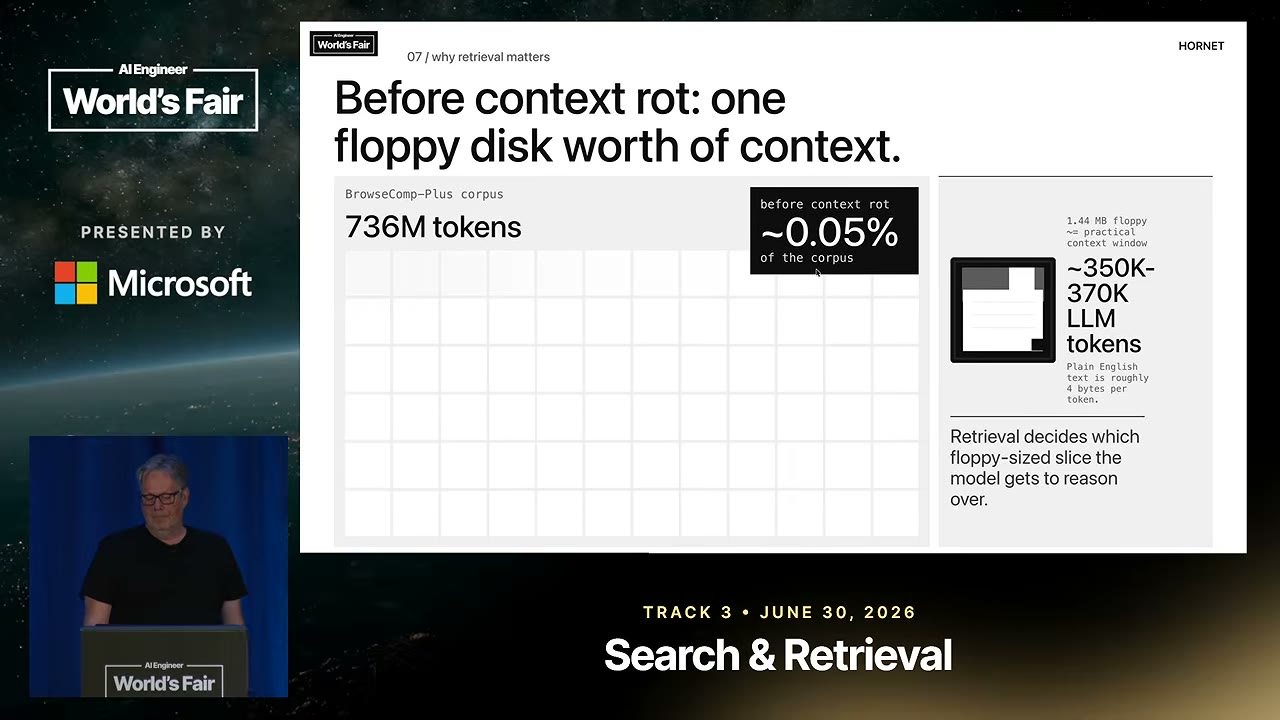
Рабочий контекст без деградации рассуждений (context rot) — ~350K токенов (1.4 МБ текста). Это всего 0.05% от типичного веб-корпуса. Ретривер критически важен, чтобы решить, что именно попадет на эту «дискету».
Тюнинг параметров дает +18%
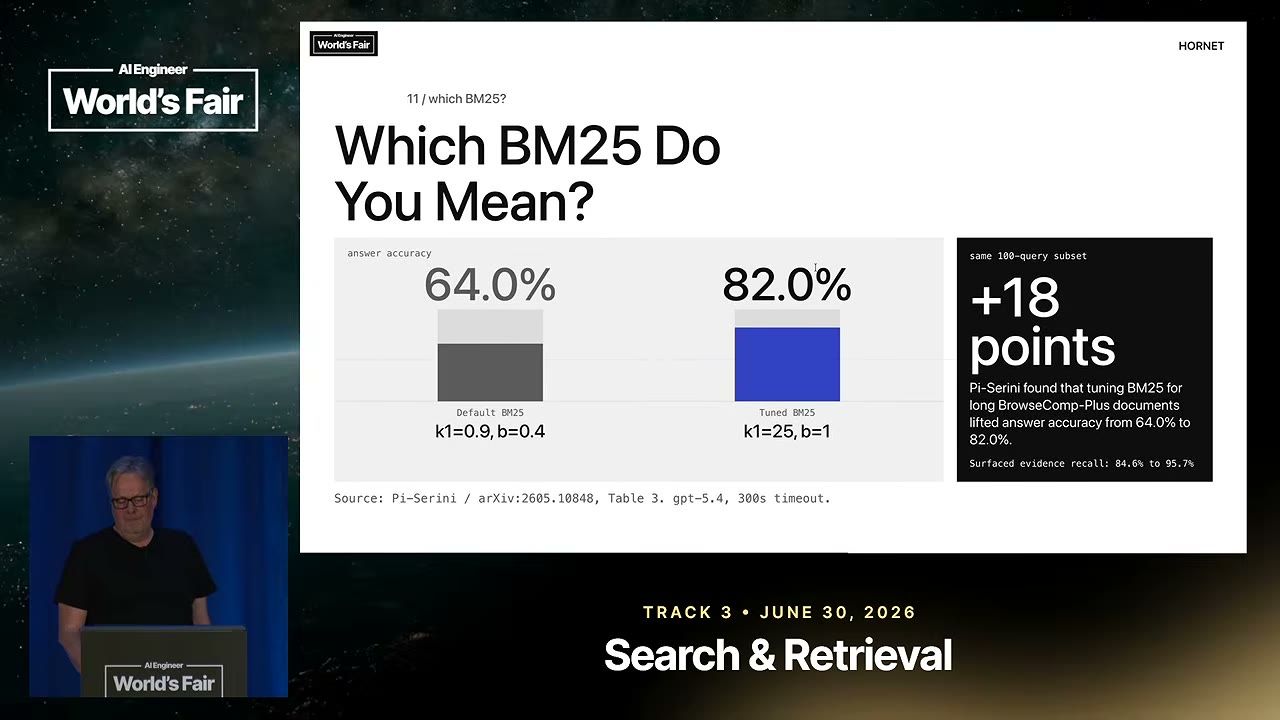
Бенчмарки объявляли BM25 устаревшим, тестируя его с дефолтными k1=0.9, b=0.4. Подбор параметров под длинные документы (k1=25, b=1) поднимает точность ответов агента с 64% до 82%.
BM25 + ripgrep в песочнице
Вместо передачи агенту готовых списков ссылок: BM25 отбирает кандидатов в виртуальную файловую систему (VFS), а агент исследует их через rg, cat и head, добиваясь точности 73.3%.
Что такое Agentic Search и как устроен его цикл
Поиск перестал быть отдельным сервисом с 10 синими ссылками. Теперь это непрерывный внутренний цикл агента.
Ю Кристьян Бергум определяет Agentic Search как «поиск внутри агентного цикла» (search inside an agent loop). Агент сталкивается с задачей (глубокое исследование темы, кодинг, решение многошаговой проблемы) и обнаруживает потребность в информации.
1. Модель (LLM)
Не просто отвечает, а решает, когда искать. Она способна переформулировать запросы на основе первых неудач, вычленять сущности и понимать, каких доказательств не хватает для завершения рассуждения.
2. Среда (Harness)
Оркестратор, предоставляющий инструменты: либо классический JSON tool-calling (search(query)), либо Code Mode (песочница с Bash/Python, где модель пишет код для поиска). Следит за контекстом и стоимостью.
3. Поисковый движок
Быстрый лексический индекс на базе BM25 (с WAND/Block-Max оптимизацией), способный обслуживать высокую частоту повторных обращений на корпусах в миллионы и миллиарды веб-страниц.
Метафора дискеты: проблема Context Rot и 0.05% корпуса
Почему расширение контекстных окон LLM до 1–2M токенов не решает проблему поиска.
В 1980-х игры и программы устанавливали с 3.5-дюймовых дискет емкостью 1.44 МБ. В пересчете на текст на английском языке (примерно 4 байта на токен) это составляет ~350 000 – 370 000 токенов.
Хотя современные модели заявляют контекст в 1M или 2M токенов, на практике после 350k токенов начинается резкое падение качества логического вывода — context rot (гниение контекста).
В тестовом корпусе бенчмарка BrowseComp-Plus содержится 736 млн токенов. Практическое окно модели способно вместить не более 0.05% от этого объема данных. Вы не можете просто «засунуть все в контекст».
Узкое место — не рассуждения, а поиск
Результаты исследования BrowseComp-Plus (ACL 2026): 830 сложных загадок на 100 195 веб-страницах.
Бенчмарк BrowseComp-Plus ставит перед агентом задачи, похожие на «вопросы из барной викторины» (pub quiz riddles). Это многошаговые запутанные вопросы, требующие найти несколько взаимосвязанных фактов в веб-архиве из 100 195 документов.
Человек против AI-агента: смена поисковой нагрузки
Анализ логов запросов: почему интуиция классического веб-поиска больше не работает.
В 2006 году AOL случайно опубликовала анонимизированные логи поисковых запросов пользователей. Они показали, что медианный человек ищет всего 2 словами («home depot», «weather forecast»). Современные логи людей показывают ровно ту же картину.
AI-агент ведет себя принципиально иначе: его медиана — 10 терминов, а средняя длина самого первого запроса в траектории составляет 19 терминов!
2 слова в среднем
Ленивый ввод, минимум конкретики. Ожидание, что поисковик сам «догадается» по кликам и популярности. Человек просматривает первые 3–5 ссылок и редко переформулирует запрос более 1–2 раз.
home depot
10–19 слов + операторы
Сверхдетальный запрос: модель извлекает из параметрической памяти имена участников, года событий, названия турниров и специфические ключевые слова, помещая критичные фразы в кавычки.
site:snooker.org 2021 UK Championship final Zhao Xintong Brecel "frame" "scores"
Which BM25 Do You Mean? — цена одной настройки (+18%)
Как дефолтные параметры тридцатилетней давности искажали академические бенчмарки.
В классической формуле BM25 есть два ключевых параметра: k1 (насыщение частоты терминов) и b (штраф за длину документа). Исторически в библиотеках типа Lucene закрепились параметры k1=0.9, b=0.4 (или k1=1.2, b=0.75), рассчитанные на короткие новостные тексты и запросы из 2 слов.
Исследователи из Pi-Serini (arXiv:2605.10848) проверили, что будет, если настроить BM25 под длинные документы веб-поиска (k1=25, b=1).
Точные совпадения
Агент знает специфические имена, SKU товаров, артикулы, почтовые индексы и даты. Эмбеддинг-модели размывают эти токены в плотные векторы фиксированного словаря, а BM25 находит их со 100% точностью.
В разы дешевле нейросетей
Современные embedding-модели для dense-retrieval достигают 7B–8B параметров. Их инференс на миллиардах страниц требует огромных кластеров GPU. BM25 работает на стандартных CPU за доли миллисекунды.
Понятно для самой LLM
Когда агент получает результат BM25, он точно видит, какие слова совпали, а какие нет. Это позволяет модели легко скорректировать запрос в следующей итерации (добавить кавычки, убрать лишнее слово).
«BM25 + grep Is All You Need» — исследование Waterloo
Почему виртуальная файловая система и bash-утилиты оказались эффективнее кастомных RAG-инструментов.
Группа исследователей Джимми Линя (Jimmy Lin) из Университета Ватерлоо опубликовала фундаментальную работу DR-DCI: Scaling Direct Corpus Interaction via Dynamic Workspace Expansion (arXiv:2606.14885).
Вместо того чтобы заставлять модель парсить JSON-выдачу поисковика, отобранные документы монтируются в локальную виртуальную файловую систему (VFS / workspace). Затем агент исследует их стандартными Unix-утилитами: ripgrep, cat, head, sed.
Классическая оценка мертва: траектории и бенчмарк на 100M страниц
Почему nDCG@10 больше ничего не значит и как Hornet масштабирует BM25 на одном сервере.
Оценка разового запроса (nDCG)
В классическом поиске оценивался один список из 10 ссылок на один запрос человека. Если на первой позиции не было идеального документа — система получала штраф. Но агент делает десятки запросов, переформулируя их на лету!
Оценка траектории решения задачи
Оценивается система целиком (Агент + Ретривер): достигнут ли финальный правильный ответ (Success Rate), сколько шагов потребовалось, какова общая задержка сессии, объем потребленных токенов и суммарная стоимость.
Хронологический таймлайн со скриншотами
Кликайте по времени для перехода к моменту на YouTube или по миниатюрам для зума слайдов.
-
Вступление: 30-летний алгоритм возвращается
Ю Кристьян Бергум (CEO Hornet.dev) начинает доклад с параллели: пока Норвегия играет на чемпионате мира, в мире AI возвращается классическая функция ранжирования 1990-х годов.
-
Что такое агентный поиск (Agentic Search)
Определение поиска внутри цикла агента. Три столпа инфраструктуры: способная модель (LLM), обвязка инструментов (Harness / Code mode) и быстрый ретривер кандидатов.
-
Откуда взялось название Best Match 25
История алгоритма: исследователи команды Окапи проводили серию экспериментов, и 25-я конфигурация оказалась самой эффективной. 40 лет оптимизаций ускорения Top-K (WAND, Block-Max).
-
Формула не изменилась — изменился пользователь
BM25 всегда был просто «бейзлайном, который все пытались победить нейросетями». Но LLM обладает огромным запасом параметрических знаний и пользуется этим инструментом иначе.
-
Бенчмарк BrowseComp-Plus: 830 загадок
830 сложных вопросов с эталонными ответами и корпус из 100 195 веб-страниц. Протокол тестирования модели в агентном цикле поиска с тулом
search(query).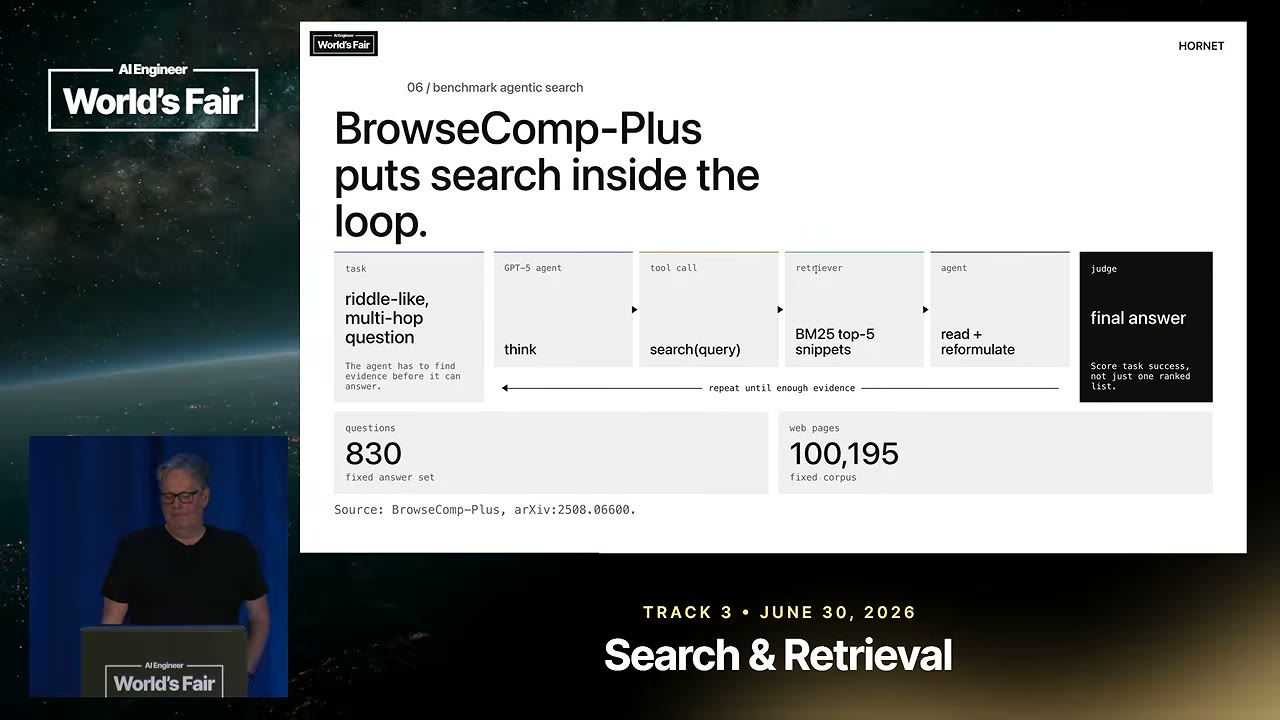
-
Контекстные окна — это дискеты на 1.44 МБ
Контекст до наступления context rot (~350k токенов) равен 1.4 МБ текста. Это лишь 0.05% от корпуса BrowseComp-Plus (736M токенов). Без ретривера агент слеп.
-
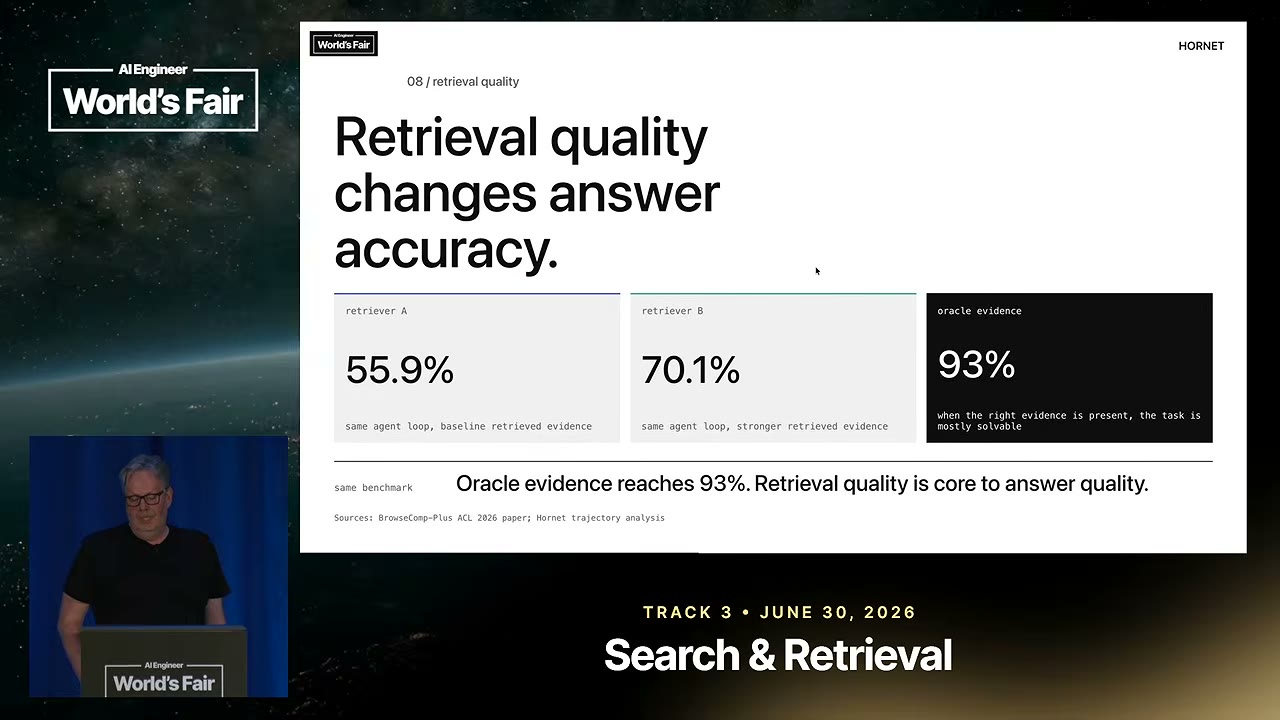
Reasoning — не проблема: Oracle дает 93%
Если улики сразу лежат в контексте, модель решает 93% сложнейших задач. Но при поиске через ретривер точность падает до 55–70%. Узкое место системы — именно ретривер.
-
Один вопрос превращается в поисковую сессию
Траектория агента: широкий разведочный запрос → чтение первых результатов → сужение по найденным сущностям → верификация дат и деталей.
-
GPT-5 формулирует профессиональные запросы
Сравнение с логами AOL: человек ищет 2 словами, агент выдает медиану в 10 слов, а первый запрос формулирует в среднем на 19 слов со сложными операторами.
-
Which BM25 Do You Mean? Прыжок на +18%
Исследование Pi-Serini: смена дефолтных гиперпараметров Lucene на оптимизированные под длинный веб-текст поднимает accuracy с 64% до 82%.
-
BM25 + grep Is All You Need (исследование Waterloo)
SERP нового поколения: BM25 выгружает кандидатов в виртуальную файловую систему (VFS), а агент исследует их через
ripgrepиsed, достигая 73.3%.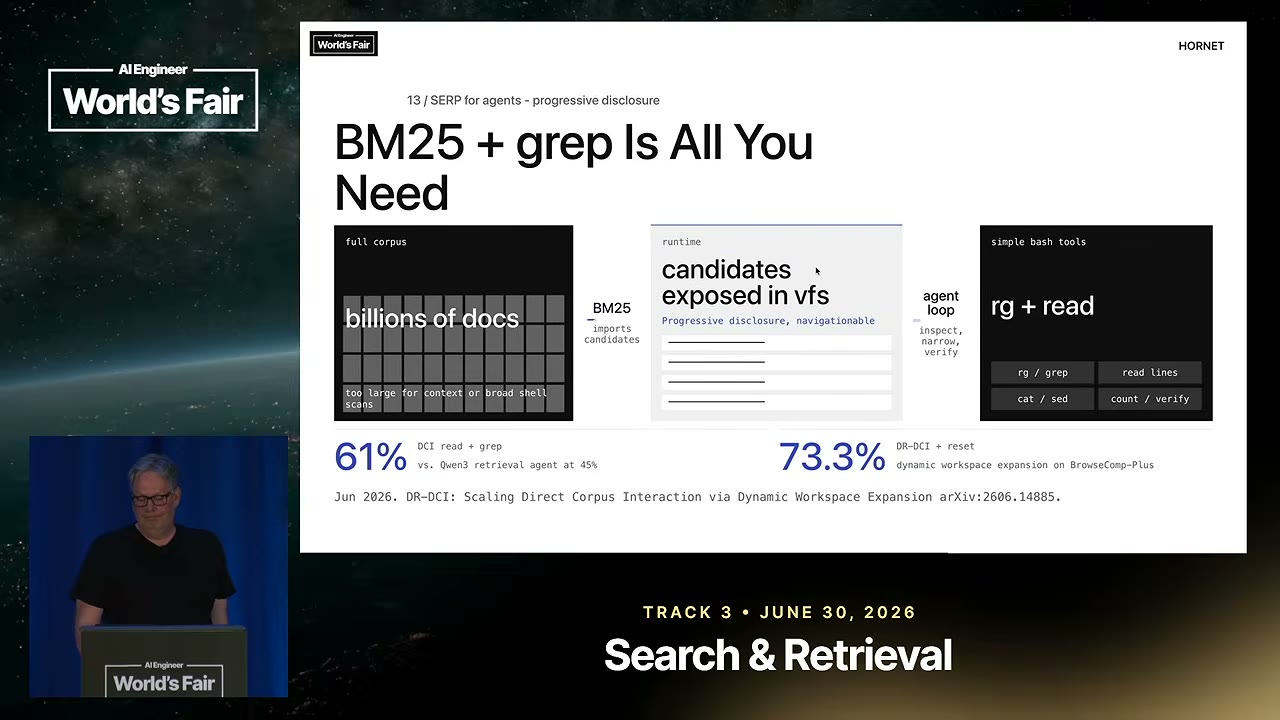
-
Смерть классической оценки (nDCG@10)
Оценивать нужно не ранжирование одного запроса, а всю сквозную траекторию работы агента: процент успеха, стоимость, задержку и число шагов.
-
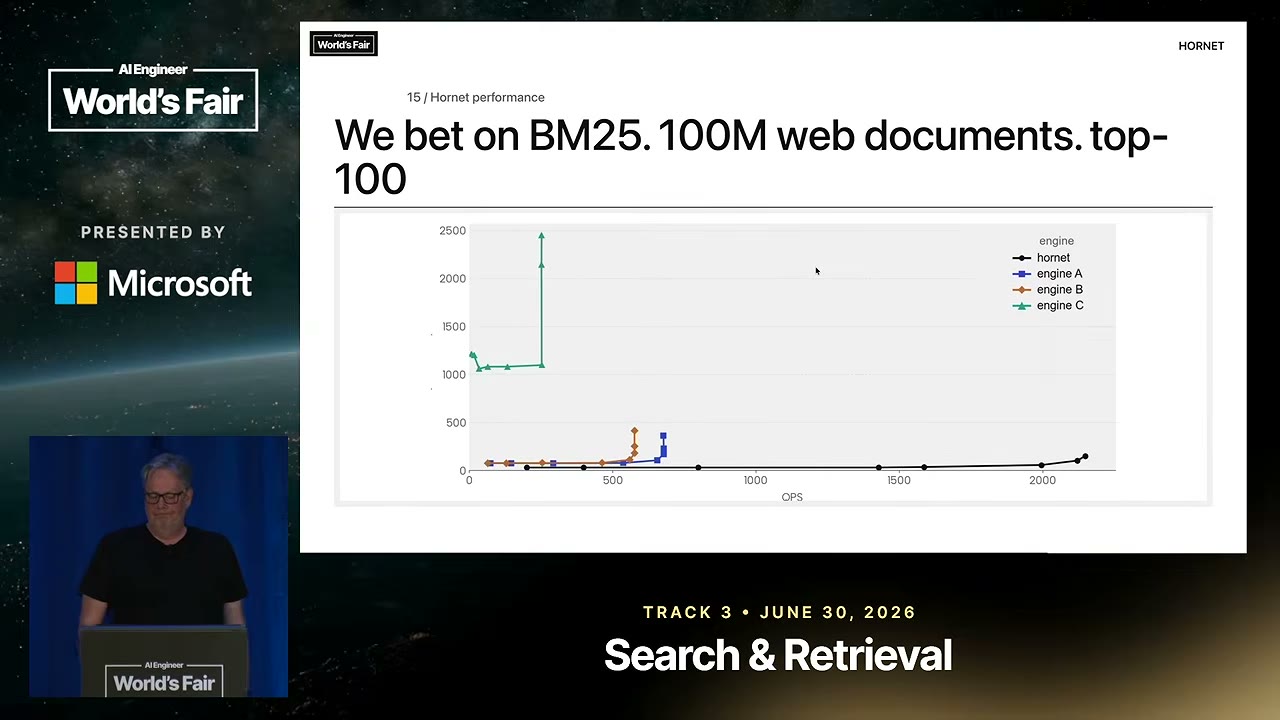
Бенчмарк Hornet на 100M веб-документов
График масштабирования: Hornet держит задержку в 50–100 мс при нагрузке свыше 2000 QPS на одной машине, опережая традиционные поисковые движки в разы.
-
Четыре главных вывода доклада
Резюме выступления: новый пользователь, важность конфигурации BM25, преимущества интерпретируемости и мощь связки BM25 + grep.
Цитаты Ю Кристьяна Бергума
Яркие формулировки из доклада о природе поиска, моделях и инфраструктуре.
«BM25 не стал внезапно магическим. Изменился пользователь. Модели обладают огромным параметрическим знанием — они знают сущности, компании, даты, почтовые индексы и артикулы. Поэтому они формируют запросы, которые ни один человек никогда бы не напечатал».
«Я люблю сравнивать контекстные окна с дискетами 1.44 МБ из 80-х. Практическое окно современных моделей до наступления деградации — около 350 000 токенов. Даже когда мы получим AGI, мы все равно будем ограничены этим окном. И что-то должно решать, что именно попадет на эту дискету».
«В традиционном поиске мы привыкли оценивать один запрос, один ранжированный список и считать nDCG. Все это теперь мертво. Новый пользователь — это агент, который переформулирует запросы, делает экспансию и идет по траектории».
«Все frontier-лаборатории оптимизируют свои модели под программирование, bash и вызов инструментов. Если вы строите свой поиск в русле того, в чем модели становятся лучше с каждым релизом — вы выигрываете автоматически».
Что внедрить в свою поисковую систему и агентный RAG
Практические шаги по оптимизации поиска для автономных агентов на основе доклада.
Упомянутые исследования и ресурсы
Научные статьи и ссылки, на которые опирался спикер в докладе.
BrowseComp-Plus
Бенчмарк глубоких веб-исследований для автономных агентов. 830 сложных многошаговых вопросов на корпусе из 100k документов.
DR-DCI: Dynamic Workspace
Исследование группы Jimmy Lin: масштабирование прямого взаимодействия с корпусом через VFS и утилиты ripgrep/bash.
Tuning BM25 for Agents
Анализ влияния параметров BM25 на качество агентного поиска: рост точности с 64% до 82% на длинных документах.